Просмотр новости
Найдите то, что Вас интересует
 Спутники
 РН
 SpaceX
 Роскосмос
 NASA
СпутникиРНSpaceXРоскосмосNASAОтказоустойчивость стоит строить вокруг критических потоков: поиска и расчёта тура, проверки наличия, бронирования, оплаты, подтверждения и обмена данными с поставщиками. Ниже: что проверить, какие сигналы считать тревожными, как тестировать и что делать, когда система работает в деградированном режиме.
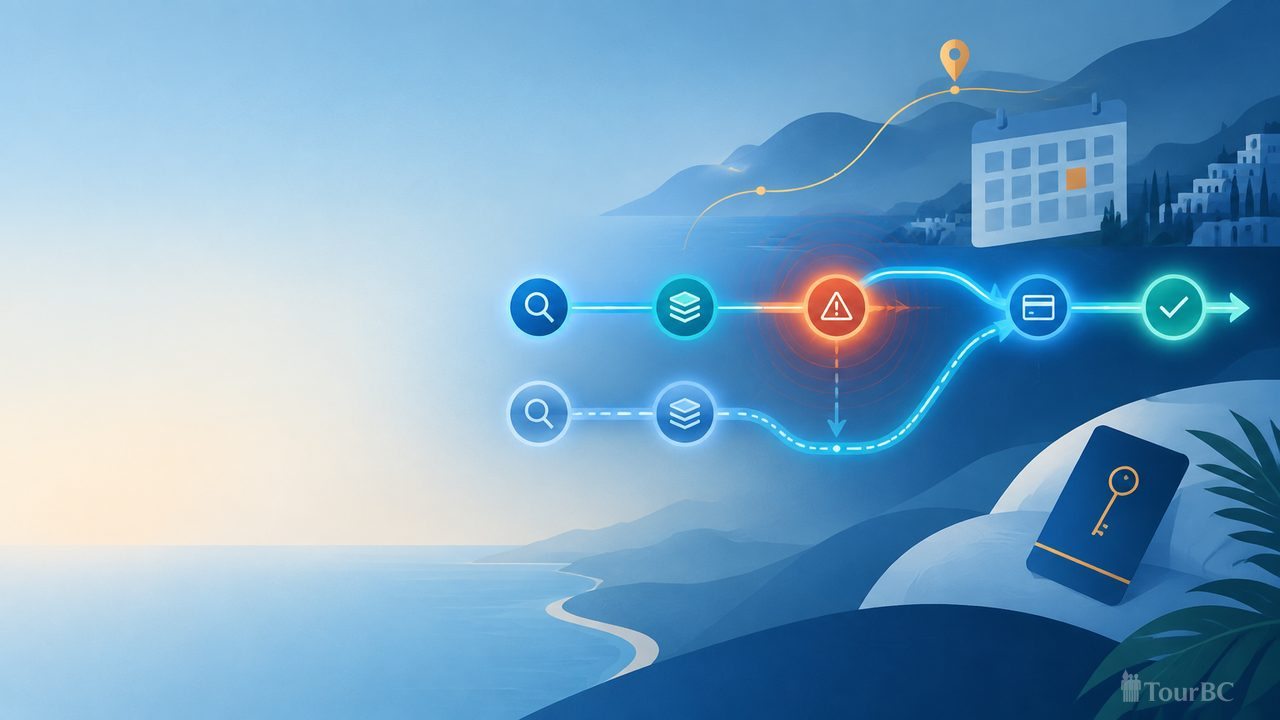
Пиковая нагрузка в туризме проверяет не «сервер вообще», а конкретную цепочку. Клиент ищет тур или номер, система проверяет наличие, считает цену, принимает оплату и выдаёт подтверждение. Обмен данными с внешними поставщиками входит в ту же цепочку, и если ломается одно звено, страдает весь поток. Поэтому чек-лист построен по потокам, а не по серверам.
Для каждого блока указано, что проверить, какой сигнал считать тревожным, как протестировать и кто отвечает. Последние два пункта, «сигнал» и «ответственный», это практическая рамка для аудита, а не требование стандартов. Конкретные пороги и роли каждая компания определяет сама.
1. Определите критические потоки и цели восстановленияНачните с перечня потоков, без которых бизнес не зарабатывает: поиск и расчёт, проверка наличия, бронирование, оплата, выдача подтверждения, обмен с поставщиками. Для каждого из них Microsoft рекомендует заранее определить SLO, RTO и RPO: какая доступность допустима, за какое время сервис должен быть восстановлен и сколько данных можно потерять.
Подробнее о постановке целей: Microsoft Azure Well-Architected: Defining reliability targets.
2. Рассчитайте пик и проверьте квотыAWS советует начинать с проверки квот сервисов, пропускной способности и сетевой топологии. Архитектура при этом должна автоматически масштабироваться, обнаруживать сбои и самовосстанавливаться.
Источник: AWS Well-Architected Framework: Reliability.
3. Зарезервируйте компоненты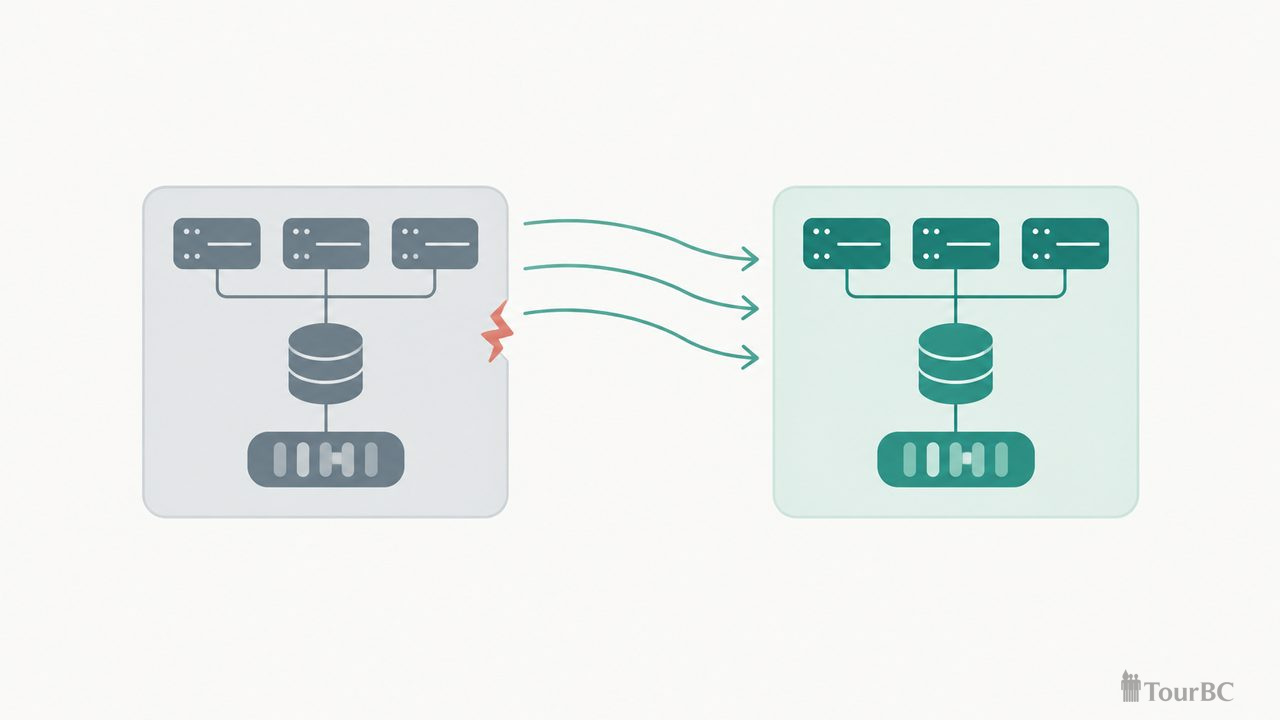
Если нагрузка размещена в нескольких зонах доступности, отказ одной зоны изолируется, а запросы обслуживают резервные зоны. Для более серьёзных сценариев AWS описывает активный и резервный регионы с переключением трафика.
Источник: AWS Well-Architected: Shared Responsibility Model for Resiliency.
4. Масштабируйте горизонтально и заранееMicrosoft рекомендует делать сервисы горизонтально масштабируемыми и stateless. Приложение не должно рассчитывать, что последовательные запросы клиента попадут на один и тот же экземпляр. Масштабировать нужно не только вычислительные ресурсы, но и базы данных, очереди и другие компоненты критического потока. Ещё стоит следить за временем запуска новых экземпляров и за самими операциями масштабирования.
Для предсказуемых сезонных или событийных пиков AWS поддерживает scheduled scaling: ёмкость растёт по расписанию. Predictive scaling наращивает её заранее по историческим закономерностям, анализируя до 14 дней истории и строя прогноз на следующие 48 часов. Прежде чем включать автоматическое масштабирование, прогноз рекомендуется оценить в режиме forecast only.
Источники: Microsoft Azure Well-Architected: Reliable scaling strategy, Amazon EC2 Auto Scaling: Choose your scaling method, Amazon EC2 Auto Scaling: How predictive scaling works.
5. Защитите API: лимиты, очереди, таймауты, повторы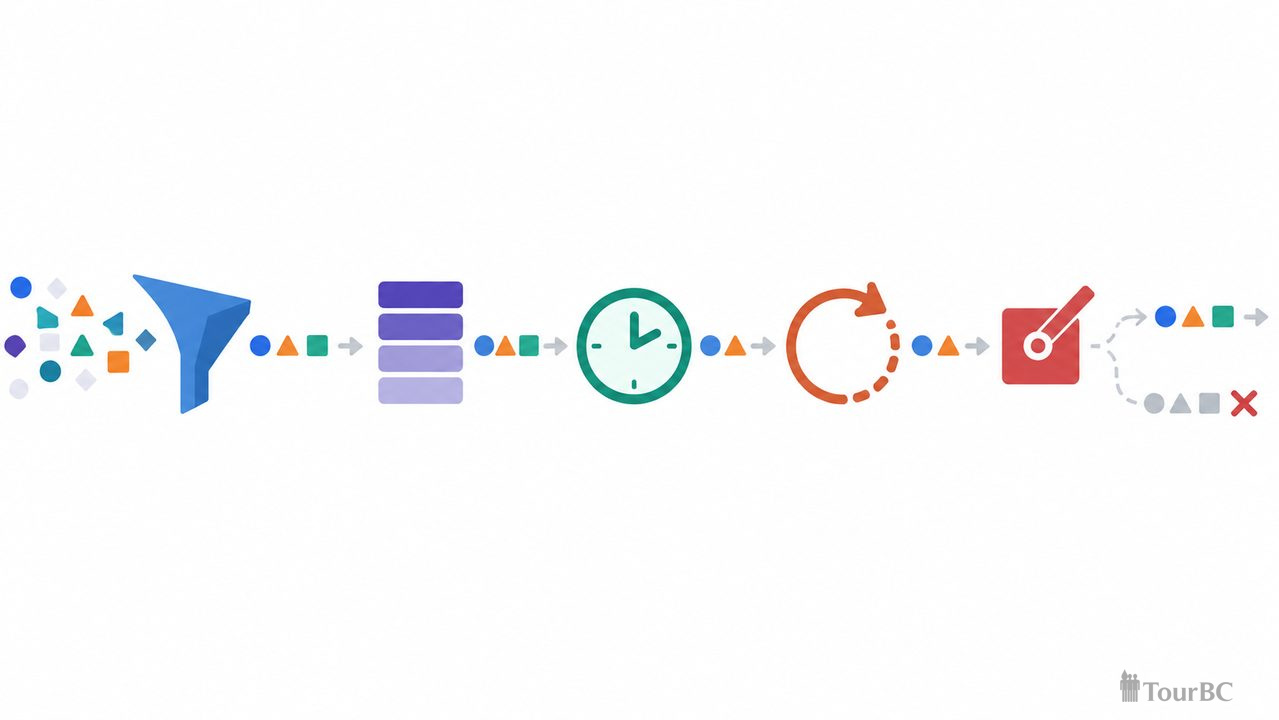
AWS относит throttling, retries, очереди, таймауты и аварийные переключатели к базовым механизмам предотвращения отказов в распределённых системах. Для туроператора и отеля это касается и собственных API, и вызовов внешних поставщиков, PMS и CRS.
Google Hotel Prices использует live pricing-запросы с типичным лимитом ответа до 4000 миллисекунд. Если уложиться не удалось, конкретная возможность показа цены может быть потеряна. Поэтому время ответа ценового сервиса нужно измерять и держать под контролем: медленный ответ стоит показа.
Google также предупреждает, что при обновлении гостиничных цен может приходить много Query-сообщений, а ответы Transaction бывают очень большими. Чтобы уменьшить объём и число сообщений, рекомендуется Changed Pricing. Если при отправке ARI-сообщения произошла ошибка HTTP-соединения, Google советует повторить запрос через 1, 5 и 20 минут, а после трёх неудачных попыток прекратить отправку и обратиться в поддержку.
Источники: Google Hotel Prices: Query Messages, Google Hotel Prices: Pricing Delivery Modes.
7. Настройте наблюдаемостьOpenTelemetry выделяет три основных типа телеметрии: traces, metrics и logs. Трассировка показывает путь одного запроса через API, приложение, очередь и базу данных, так что по ней проще понять, на каком звене поток застрял. Azure рекомендует постоянно измерять состояние системы по техническим и пользовательским показателям, следить за распределением нагрузки между резервными экземплярами и сохранять данные для расследования инцидентов.
Источники: OpenTelemetry: Observability Primer, Microsoft Azure Well-Architected: Monitoring workload reliability.
8. Подготовьте восстановление и регулярно его проверяйтеNIST указывает, что планы восстановления нужно периодически проверять и повторно тестировать после изменений в организации или системе. Испытания должны охватывать восстановление на альтернативной платформе, внешние соединения, производительность и возврат к штатной работе. Последнее легко упустить: мало восстановиться, нужно ещё вернуться к обычной схеме.
AWS рекомендует регулярно тестировать функциональность, масштабирование, производительность и отказоустойчивость, в том числе через инъекцию отказов, chaos engineering и game days. Тестовая среда должна быть максимально близка к production.
Источники: NIST SP 800-34 Rev. 1: Contingency Planning Guide, AWS Well-Architected: How do you test reliability?.
Сценарии деградации: что делать, если нагрузка выше расчётной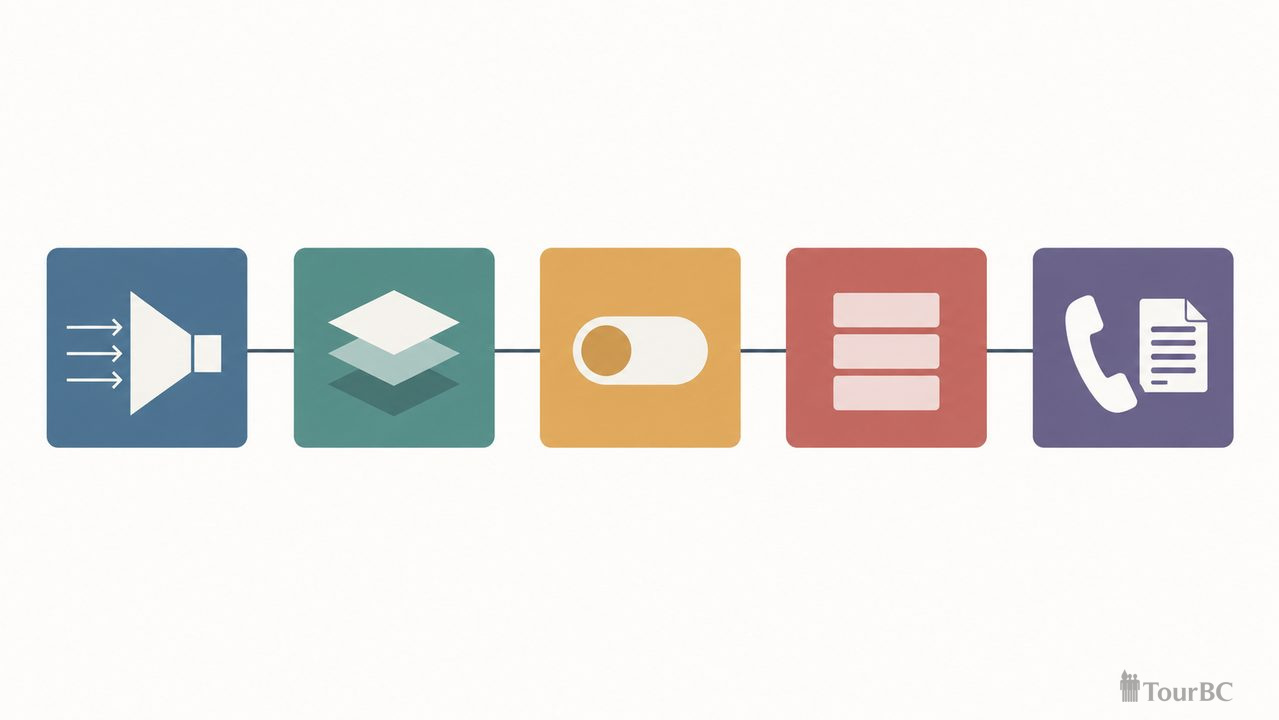
Полностью исключить перегрузку нельзя, поэтому заранее решите, как система будет работать в ограниченном режиме. За основу можно взять механизмы, которые AWS считает базовыми: throttling, очереди, аварийные переключатели. Конкретные правила каждая компания задаёт исходя из своих потоков.
Для каждого сценария зафиксируйте, кто решает о включении, по какому сигналу и как система возвращается к штатной работе. Эти сценарии тоже нужно отрабатывать на учениях.
Краткий итог для аудита| # | Наименование новости | Тональность | Информативность | Дата публикации |
|---|---|---|---|---|
| 1 | Платежи в туризме: как выбрать онлайн-кассу, эквайринг, СБП и оплату частями | 0 | 10.42 | 22-07-2026 |
| 2 | Блог для турагентства и отеля: как выстроить стратегию под органический поиск | 0 | 6.32 | 10-09-2026 |
| 3 | API-интеграции в турбизнесе: пять вопросов до подключения к поставщикам | 0 | 10.85 | 24-09-2026 |
| 4 | Управление требованиями и закупками в ИТ-проектах: снижаем вероятность провала проекта | 5 | 7 | 16-02-2026 |
| 5 | Туроператоры не фиксируют спада бронирований путевок в Турцию | 0 | 0 | 07-02-2023 |
| 6 | SEO на этапе разработки сайта: что согласовать до запуска | 0 | 6.75 | 01-01-1970 |
| 7 | Меньше поездок, выше чеки: как россияне меняют привычки отдыха | 1 | 18.29 | 13-10-2026 |
| 8 | Российские решения для ЖКХ и ИТС | 0 | 9.6 | 05-08-2026 |
| 9 | Как подготовить сайт к платному трафику в 2026 году и не терять лиды после клика | 0 | 18.95 | 28-07-2026 |
| 10 | Почему собственник не слышит CIO: ошибки, которые совершают даже сильные ИТ-директора | 0 | 16.9 | 17-09-2026 |